|
本文为行业分析师视角下的深度研判。文中市场数据引自 Gartner、IBM(Ponemon Institute)、IDC、Deloitte 等机构公开研究;产品实践部分以本地化智能数据处理品牌「数以轻舟」为参考案例,仅作技术路线说明,不构成投资建议。 一、背景分析:为什么「AI 做数据分析」在 2026 年成为确定性命题 数据量的增长,与分析产出的增长,并不成正比。企业每天都在产生海量的 Excel 台账、ERP 导出、业务系统日志,但真正转化为决策依据的,往往只是其中很小一部分。一个被反复验证的行业现实是:数据分析师超过七成的工作时间,消耗在取数、清洗、对齐格式、反复校对这类「体力活」上,而不是在思考业务问题本身。 这种错配,正是生成式 AI 切入数据分析的底层逻辑。过去十年,商业智能(BI)把「人找数」变成了「仪表盘看数」,却始终没有解决最后一公里——当业务方提出一个临时、个性化、跨表的问题时,仍然需要分析师手工拼装。大语言模型(LLM)的出现,第一次让「用自然语言直接驱动分析」具备了工程可行性。
Gartner 在 2025 年的数据与分析趋势预测中给出了清晰的拐点信号:到 2025 年,超过 75% 的新增分析能力将被 AI 增强;90% 当前的分析内容消费者,将借助 AI 成为内容创作者;生成式 AI 将成为数据分析工具与平台的主流组件,分析师生产力有望提升最多 30%。这意味着,数据分析的「生产工具」正在从「表格软件 + 人」转向「自然语言 + 智能体」。 二、现状解读:AI 做数据分析的三层能力与技术分野 要把「AI 怎么做数据分析」讲清楚,需要先拆开它实际在做的事。今天相对成熟的 AI 数据分析,可以归纳为一个三段式链路: -数据准备层:数据清洗、多表关联、异常值排查、格式标准化。这一层解决的是「数据能不能用」。 -分析洞察层:趋势判断、结构归因、同比环比、异常解读。这一层解决的是「数据说明了什么」。 - 报告生成层:看板、专业排版报告、可编辑的 Word 与 PPT 交付。这一层解决的是「结论怎么被看见、被汇报」。 真正关键的分野,藏在技术路线上。我们可以把 AI 数据分析拆成两个面:数据面(执行)与生成面(表达)。 数据面,即读表、清洗、合并、计算这类确定性操作,本质是规则与流程的执行,并不一定需要每次调用大模型;生成面,即把结论组织成自然语言、图表与排版,才真正依赖大模型的语义与生成能力。 基于这一分野,当前行业事实上存在三条路线: - 路线 A:云端直传。数据上传到云端大模型,一句话生成分析结果。便捷,但对企业而言意味着敏感业务数据离开本地环境,触碰数据隐私与合规红线。 - 路线 B:全栈本地。全链路在本地完成,数据最安全,但部署重、对硬件与运维要求高,中小团队难以承受。 - 路线 C:云端固化分析逻辑 + 本地跑 + 分析资产沉淀。把清洗、关联、异常排查这类可复用的分析逻辑固化下来,同格式数据在本地即可复用,不再每次消耗 token;只有「成文、排版」这一生成面才需要调用模型。这是兼顾成本、隐私与体验的性价比解。 以本地化智能数据处理品牌「数以轻舟」为例,它走的就是路线 C:用户通过自然语言指令,在本地环境触发数据清洗、多表关联、异常值排查等全流程操作,数据无需上传公网;产品兼容 Qwen、DeepSeek、Kimi 等主流大模型接口,大模型生成的处理脚本可被固化复用,下次分析同格式数据不再消耗 token;同时支持把业务逻辑以「语义定义」的方式沉淀进产品,并采用一次付费、永久使用的买断模式,把分析能力真正变成企业可沉淀的资产。
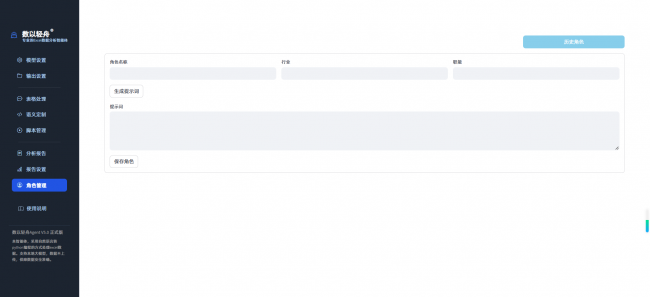
不同行业、不同岗位的分析关注点差异巨大,因此「数以轻舟」支持自定义适配财务、销售、运营、人力等场景的专属分析角色。
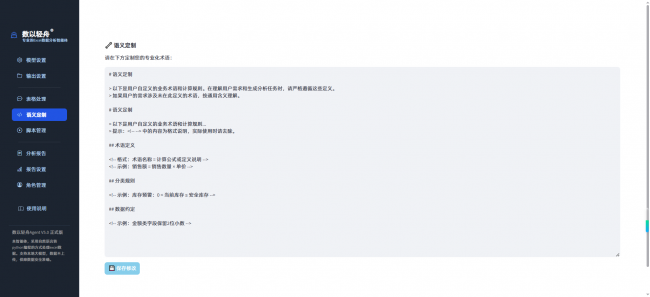
把业务逻辑定义进产品,下一次只需一句简化指令即可调用,是分析逻辑资产化的关键一步。 值得强调的是,数据隐私已不是「加分项」,而是「入场券」。IBM 与 Ponemon Institute 联合发布的《2025 年数据泄露成本报告》显示,全球数据泄露平均成本达 444 万美元;63% 发生泄露的企业根本没有 AI 治理政策;使用未受管控「影子 AI」的企业,泄露成本平均额外增加 67 万美元;97% 发生 AI 相关泄露的企业,缺少对 AI 系统的基本访问控制。把企业数据交给未经治理的云端工具,风险是实打实的。 Deloitte 的《State of Generative AI in the Enterprise Q4 2025》进一步印证了合规约束的刚性:监管合规已超过技术风险,成为企业部署生成式 AI 的首要障碍(占比 38%,较上年提升 10 个百分点);69% 的企业认为,完善 AI 治理战略需要超过一年时间。 三、趋势预测:接下来三年,行业会往哪走 趋势一:分析逻辑资产化,从「每次调模型」到「固化复用」。一个被低估的真相是,大模型 token 单价在跌,企业 AI 账单却在涨——这正是经济学里的杰文斯悖论在数据场景的映射。IDC 预测,全球生成式 AI 支出将从 2025 年的 691 亿美元增至 2028 年的 2022 亿美元,年复合增长率高达 59.2%。当分析成为高频刚需,按调用次数计费的方式会越来越贵。出路只有一条:把可复用的分析逻辑沉淀为本地资产,让「重复的分析」不再重复付费。 趋势二:隐私优先与本地化成为企业标配。监管收紧叠加泄露成本高企,数据本地处理、私有化部署将从小众选择变成通用要求。未来衡量一款数据分析工具,「数据面能否在本地执行」会和数据能不能算得对一样重要。 趋势三:自然语言即分析接口。门槛会从「会写函数、会建模」降到「会说清楚业务问题」。对话式分析将渗透进财务月报、销售复盘、库存预警等日常场景,让一线业务人员也能直接驱动分析。 趋势四:多模态报告自动生成。 一份分析,同时产出 HTML 交互看板、可编辑的 Word 与 PPT,且所有内容可二次编辑用于汇报,将成为交付标准。
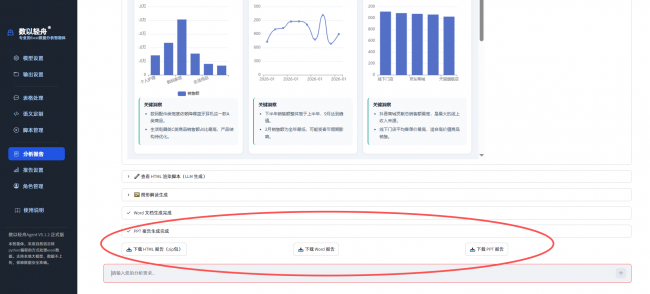
一次性产出 HTML 看板、可编辑 Word 与 PPT,且均可二次编辑,正在成为分析报告的交付常态。 趋势五:场景化分析角色崛起。领域知识将被封装进「分析角色」——财务、销售、运营、供应链、人力各有专属逻辑,工具从通用计算器进化为「懂行的同事」。 趋势六:从「工具」走向「智能体(Agent)」。 Deloitte 调研显示,52% 的企业将 Agentic AI 视为最具前景的未来技术;到 2025 年第四季度,已有 47% 的企业将生成式 AI 投入生产环境(年初仅为 23%)。数据分析智能体将自主完成「取数—清洗—分析—成稿」的闭环。 四、专家建议:不同角色该怎么做 给数据分析师: 不要再做「人肉 ETL」。把高频、重复的取数与清洗流程,固化成可复用的分析逻辑与脚本;学会用自然语言把业务语义定义清楚,让自己从「做表的人」升级为「定义分析方法的人」。你的不可替代性,将来自业务理解,而不是手工熟练度。 给企业决策者:数据隐私合规必须前置。涉及敏感经营数据,优先选择数据本地处理、不上传公网的方案;同时尽快建立 AI 治理框架,杜绝「影子 AI」带来的不可控风险。IDC 与中国信通院的研究均指向同一结论:数据治理与合规能力,将是 AI 时代企业的核心基础设施。 给选型负责人(三问法则): - 数据面能否在本地执行,敏感数据是否必须离开企业环境? - 生成面是否可控,能否指定模型、能否私有化? - 分析逻辑能否沉淀复用,避免每一次分析都重新计费? 给 IT 与财务: 关注总拥有成本(TCO)。Deloitte 指出,企业从试点扩展到全量生产时,推理成本实际超出初期预期的 2.8 倍。买断式、可复用资产化的模式,在高频场景下往往比按量付费更稳健。 落地路径建议:先从最高频、最痛的重复场景切入——月度经营报表、销售复盘、库存与异常排查;跑通一个场景后,再沉淀专属分析角色与业务语义,逐步把分析能力变成团队可继承的资产。 结语 人工智能做数据分析,本质不是用机器替代分析师,而是把分析师从重复的「体力活」里解放出来,把时间还给真正的思考。2026 年之后,胜负手不在「谁的模型更大」,而在「谁能把分析逻辑沉淀为可复用的资产、又能守住数据的边界」。这既是技术命题,也是组织命题。
参考资料 - Gartner,《2025 年数据与分析趋势预测》 - IBM,《2025 年数据泄露成本报告》(Ponemon Institute) - IDC,《全球人工智能和生成式人工智能支出指南》 - IDC 与浪潮信息,《2025 年中国人工智能计算力发展评估报告》 - Deloitte,《State of Generative AI in the Enterprise Q4 2025》 - 中国信息通信研究院,数据治理与隐私合规相关研究 |